前言
在各类项目开发中,搜索始终是用户体验的核心功能之一。无论是个人博客、产品官网、文档知识库,还是企业后台、内容管理系统,用户都依赖搜索快速定位自己需要的信息。但实际开发里,很多人的搜索方案都比较将就:要么直接用数据库模糊查询,要么硬上Elasticsearch,结果要么搜索体验拉胯,要么运维成本居高不下。不少中小项目其实只需要一个够用、稳定、速度不错的全文检索,却被迫去维护一套复杂笨重的服务,这也是很多开发者真实遇到的难题。
Elasticsearch的能力毋庸置疑,生态完善,海量数据场景下表现很强。但大多数普通项目根本用不到它全部能力,反而要承受资源占用高、配置繁琐、学习成本高的问题。只是为了实现简单的全文检索、关键词高亮,就要花大量时间调参、处理集群问题,对小团队和个人开发者来说,实在有点得不偿失。
数据库 LIKE 查询的坑也很现实。少量数据时还能跑,数据一多查询就明显变慢。而且原生数据库没有分词、拼写纠错、结果权重排序这些能力。用户打错字、简写关键词,就搜不到任何结果。想要改善体验,就得自己写一堆逻辑去实现分词和排序,工作量大,效果还很难做好。
这种场景下,Meilisearch就是一个很合适的选择。使用Rust编写,轻量稳定,主打开箱即用。不用复杂配置,不用额外插件,自带错别字容错、中文分词、搜索高亮、多字段排序这些常用能力。单二进制文件就能启动,API简洁,任何编程语言都能快速接入,百万级数据也能做到毫秒级返回。
本文主打实战,不会堆砌晦涩理论。我们从部署启动开始,一步步完成索引创建、数据导入、检索调用,带你完整跑通Meilisearch,快速给你的业务接入一套好用、高速的全文搜索。
1.Meilisearch是什么?
Meilisearch是一款开源轻量的全文搜索引擎,使用 Rust 语言开发,用来给网站、文档、后台系统快速增加搜索能力,替代笨重的Elasticsearch,跨平台支持Windows、Linux、macOS、NAS,自带简洁的HTTP API。
核心特点
- 开箱即用,配置极少,不需要复杂调参,不用额外安装分词插件,部署完成就能直接导入数据开始检索。
- 自带智能搜索能力:内置错别字容错、中文分词、关键词高亮、自定义排序、结果过滤,这是它最亮眼的优势。
- 性能优秀、资源占用低,百万级文档也能做到毫秒级返回搜索结果,适合小主机、NAS长期稳定运行。
- 简单的HTTP API,几乎所有编程语言都能快速对接,上手门槛很低。
Meilisearch核心能力
- 全文检索,多字段同时搜索
- 拼写纠错,用户打错字也能匹配结果
- 搜索关键词高亮展示
- 自定义排序、过滤、分页
- 支持设置字段权重,优先展示更相关内容
适合什么人使用
- 个人开发者:博客、文档站、个人项目想快速加搜索,不想折腾复杂服务
- 中小团队:内部知识库、后台管理系统、中小型商城,需要低成本实现优质搜索体验
- NAS / 低功耗主机玩家:在本地小设备上部署轻量搜索服务,资源消耗小
- 不想维护Elasticsearch的开发人员:需要全文检索能力,但希望降低部署和运维成本
Meilisearch和Elasticsearch的关系
- Meilisearch:轻量搜索引擎,主打简单易用,适合中小项目、文档站、内部系统。
- Elasticsearch:重型搜索引擎,功能极其丰富,适合海量数据、复杂检索场景,但是部署维护成本高。
2.前提条件
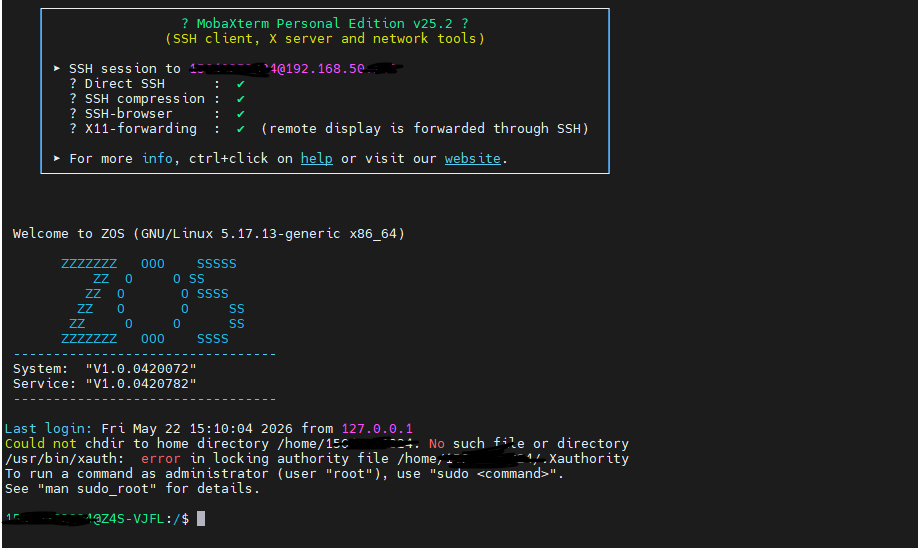
2.1ssh远程连接到极空间
- 开启【SSH 服务】
- 使用终端(Windows PowerShell / Mac Terminal)登录:
ssh root@IP
没有ssh的小伙伴可以参考这篇文章:
连接成功:极空间别再吃灰了!开启SSH,秒变全能服务器! – cpolar 极点云官网
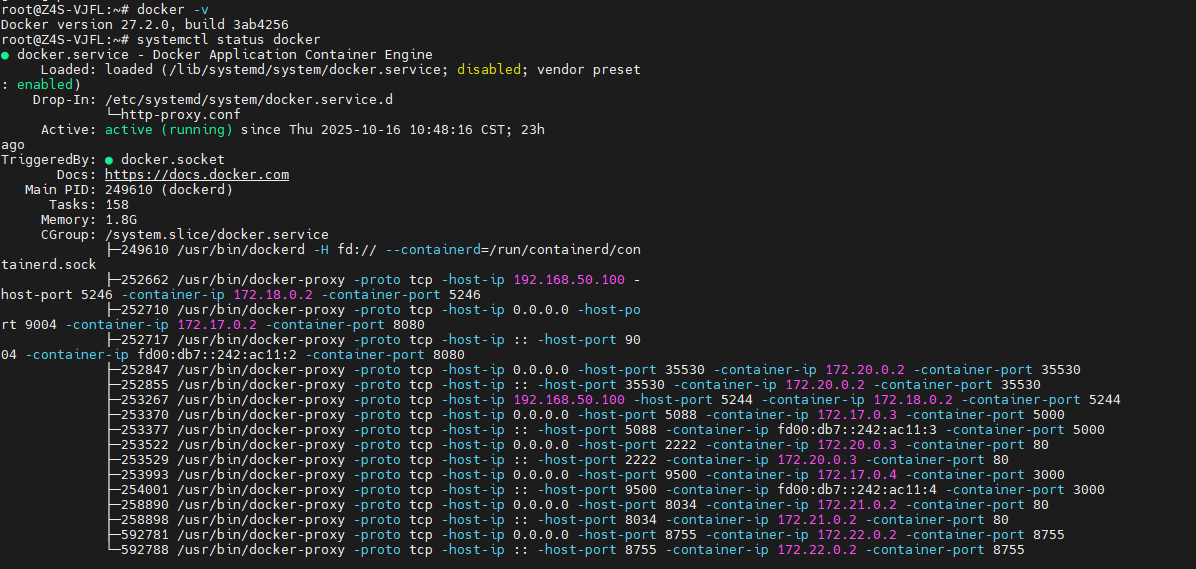
2.2验证docker是否开启
使用命令:
docker -v
systemctl status -v
没有docker的小伙伴可以参考这篇文章:极空间开箱实录:从拆箱到远程访问保姆级教程,30分钟上手! – cpolar 极点云官网
3.安装Meilisearch
3.1 命令行终端
下载并安装Meilisearch。此命令会将最新版本的Meilisearch安装到您的本地机器上:
curl -L https://install.meilisearch.com | sh
接下来,在您的终端中运行以下命令以启动Meilisearch:
./meilisearch --master-key="aSampleMasterKey"
3.2 docker一键部署
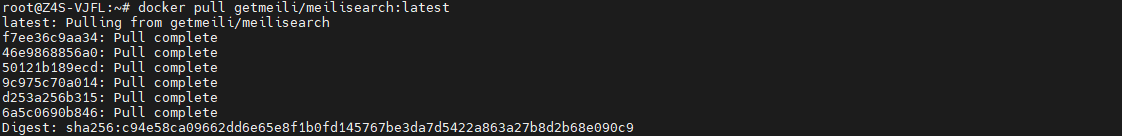
下载docker镜像:
docker pull getmeili/meilisearch:latest
运行meilisearch容器:

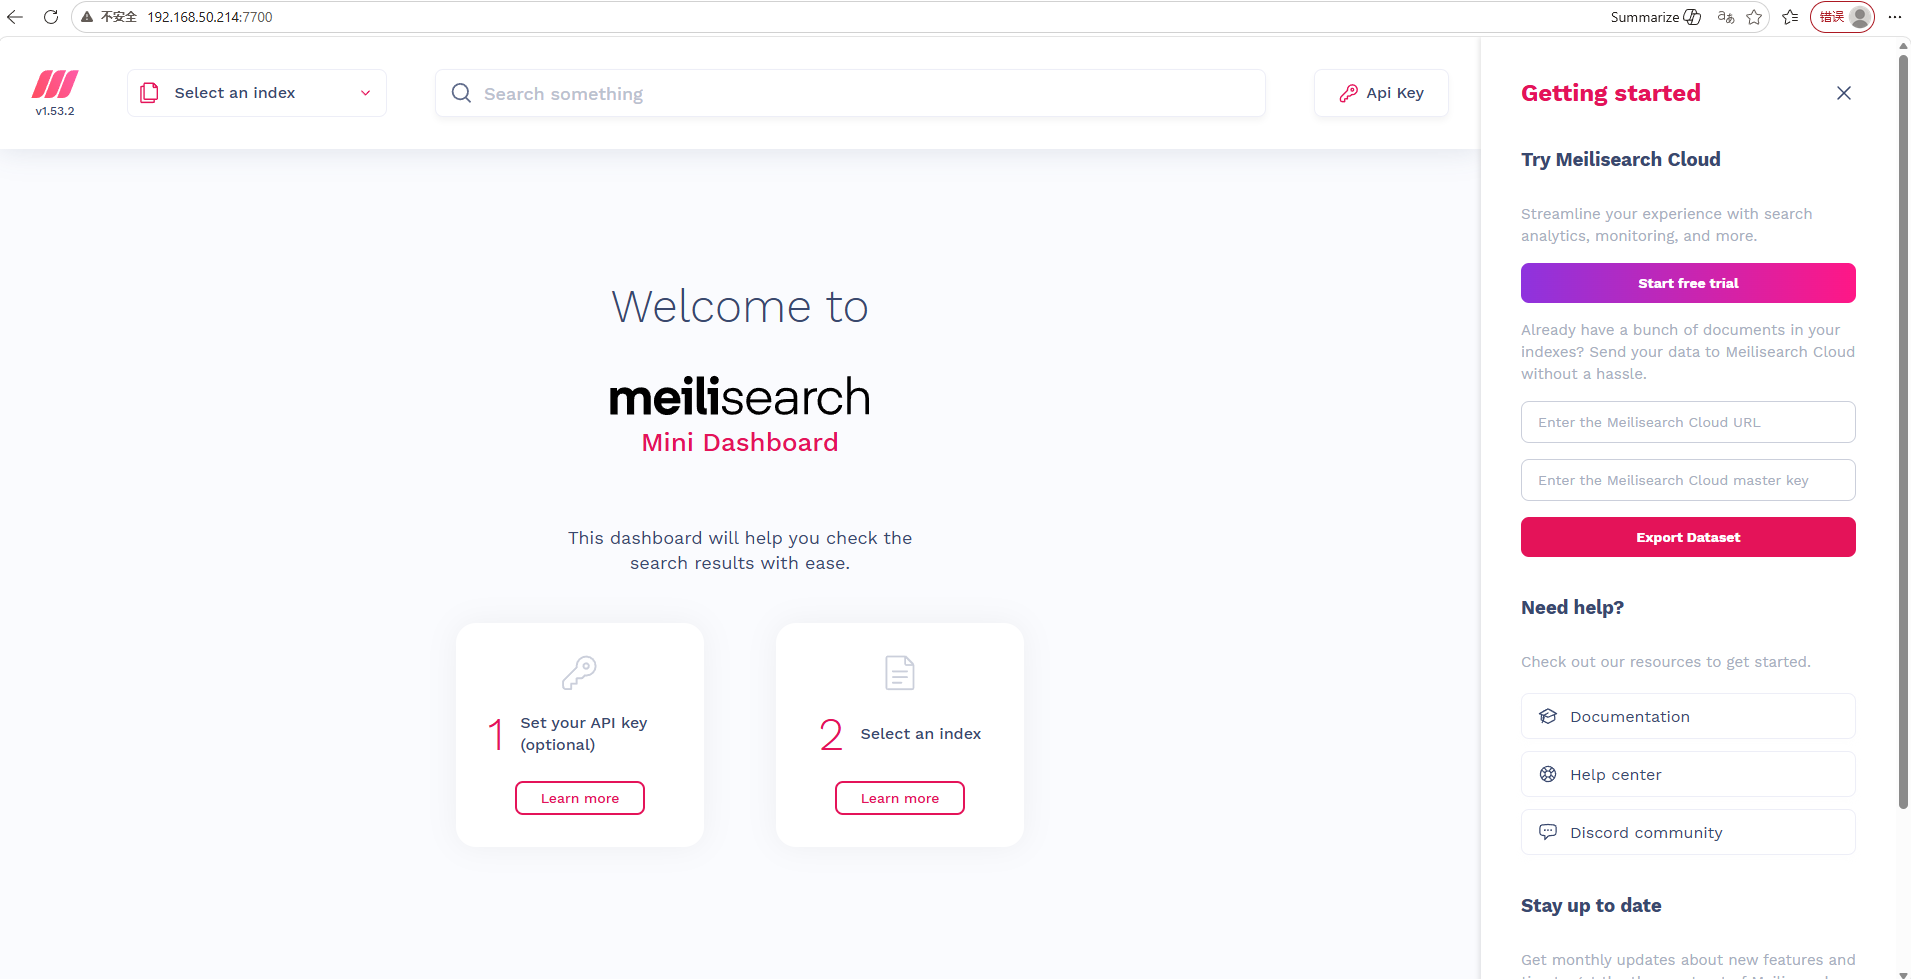
部署完成后,在浏览器中输入 http://极空间IP:7700 就能看到Meilisearch的界面:
4.使用Meilisearch
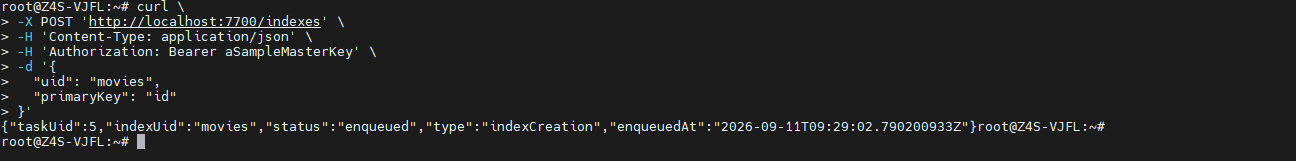
4.1 创建索引
字段含义
uid:索引唯一标识,索引名称,这里就是movies,一旦创建不能修改。createdAt:索引创建的时间(UTC 时间)updatedAt:索引最后一次更新时间,新增 / 修改文档、修改索引配置都会更新这个值primaryKey:主键字段名称,本例为id,用来唯一区分每一条文档
curl \
-X POST 'http://localhost:7700/indexes' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '{
  "uid": "movies",
  "primaryKey": "id"
}'
查看单个索引详情(查看这个 JSON 的命令)
curl \
-H 'Authorization: Bearer aSampleMasterKey' \
'http://localhost:7700/indexes/movies'

查看全部索引列表
curl \
-H 'Authorization: Bearer aSampleMasterKey' \
'http://localhost:7700/indexes'

导入成功:
4.2 导入文档
方法1:直接在命令行内写入 JSON 数据(推荐快速测试,无需新建文件)
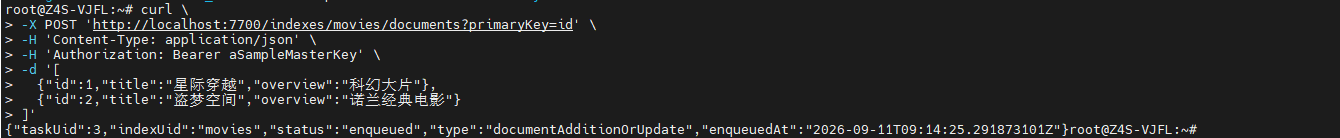
添加文档 通过curl调用Meilisearch的API,往movies这个索引里写入两条电影数据。primaryKey=id指定用id字段作为每条数据的唯一标识。
curl \
-X POST 'http://localhost:7700/indexes/movies/documents?primaryKey=id' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '[
  {"id":1,"title":"星际穿越","overview":"科幻大片"},
  {"id":2,"title":"盗梦空间","overview":"诺兰经典电影"}
]'
方法 2:创建movies.json文件,再导入(适合大批量导入)
新建文件:
创建本地JSON数据文件 cat > 是 Linux 命令,在当前目录新建movies.json文件,并把电影JSON内容写入保存。后续可以把大量业务数据放到这个文件,适合大批量导入。
cat > movies.json <<EOF
[
  {"id":1,"title":"星际穿越","overview":"科幻大片"},
  {"id":2,"title":"盗梦空间","overview":"诺兰经典电影"}
]
EOF
执行导入命令:
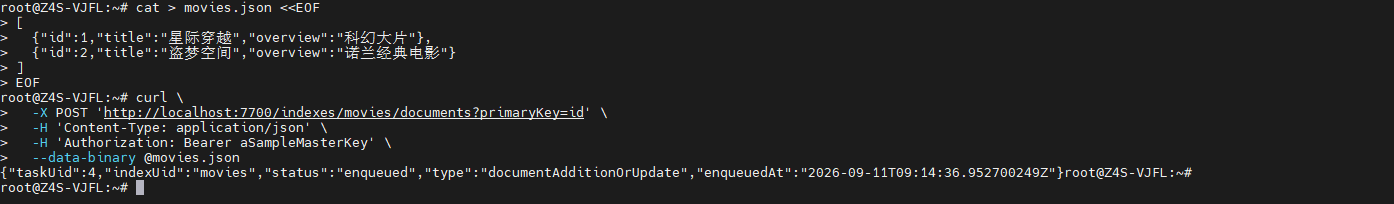
读取本地movies.json文件,批量导入文档 --data-binary @movies.json 就是读取刚才新建的本地文件,上传给Meilisearch。同样返回任务入队成功。
curl \
>   -X POST 'http://localhost:7700/indexes/movies/documents?primaryKey=id' \
>   -H 'Content-Type: application/json' \
>   -H 'Authorization: Bearer aSampleMasterKey' \
>   --data-binary @movies.json
{"taskUid":4,"indexUid":"movies","status":"enqueued","type":"documentAdditionOrUpdate","enqueuedAt":"2026-09-11T09:14:36.952700249Z"}
查看任务是否执行完成:
curl \
  -H 'Authorization: Bearer aSampleMasterKey' \
  'http://localhost:7700/tasks/3'

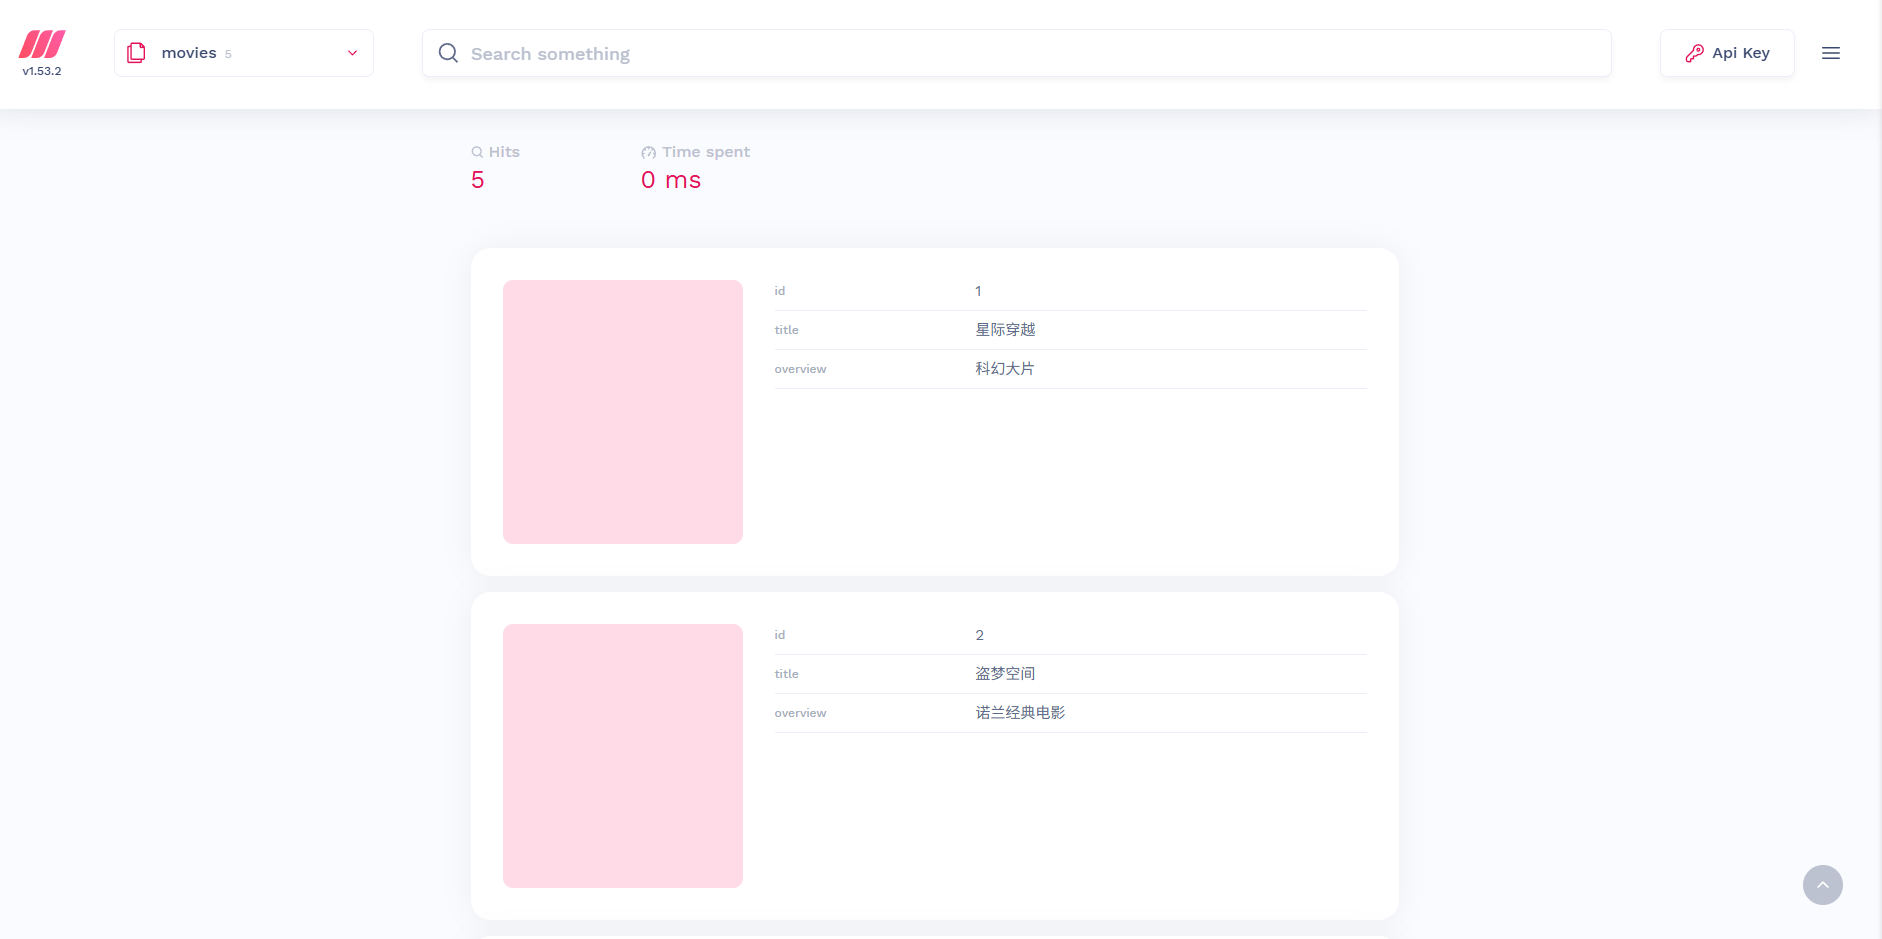
统计信息成功~
测试命令:
curl \
  -X POST 'http://localhost:7700/indexes/movies/search' \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer aSampleMasterKey' \
  -d '{ "q": "星际" }'

4.3 搜索数据
基础搜索命令
curl \
-X POST 'http://localhost:7700/indexes/books/search' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '{
  "q": "三体"
}'

常用进阶搜索示例
示例 1:只返回指定字段(只展示书名和作者,不返回年份分类)
curl \
-X POST 'http://localhost:7700/indexes/books/search' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '{
  "q": "科幻",
  "attributesToRetrieve": ["title", "author"]
}'

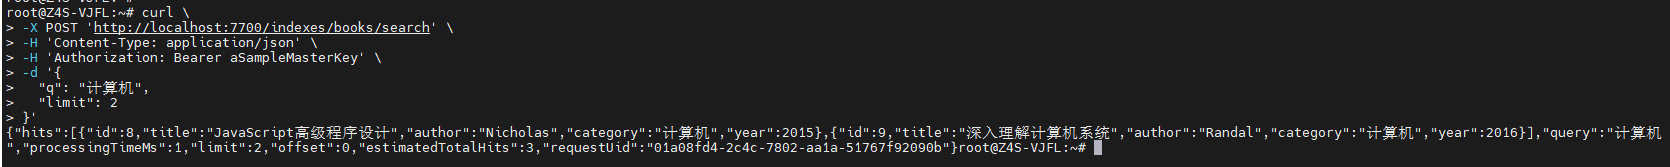
示例 2:分页搜索,只取前 2 条结果
curl \
-X POST 'http://localhost:7700/indexes/books/search' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '{
  "q": "计算机",
  "limit": 2
}'
示例 3:组合过滤,搜索科幻类书籍,并且年份大于 2000
curl \
-X POST 'http://localhost:7700/indexes/books/search' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '{
  "q": "科幻",
  "filter": "year > 2000"
}'

示例 4:错别字容错测试(输入错别字,依然能搜到三体)
curl \
-X POST 'http://localhost:7700/indexes/books/search' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer aSampleMasterKey' \
-d '{
  "q": "三提"
}'

返回结果字段简单解读
{
  "hits": [
    {"id":1,"title":"三体","author":"刘慈欣","category":"科幻","year":2008},
    ...
  ],
  "query": "三体",
  "processingTimeMs": 0,
  "estimatedTotalHits": 3
}
hits:搜索命中的数据数组,就是搜索结果列表query:你输入的搜索关键词processingTimeMs:检索耗时,一般都是毫秒级estimatedTotalHits:预估匹配到的文档总数
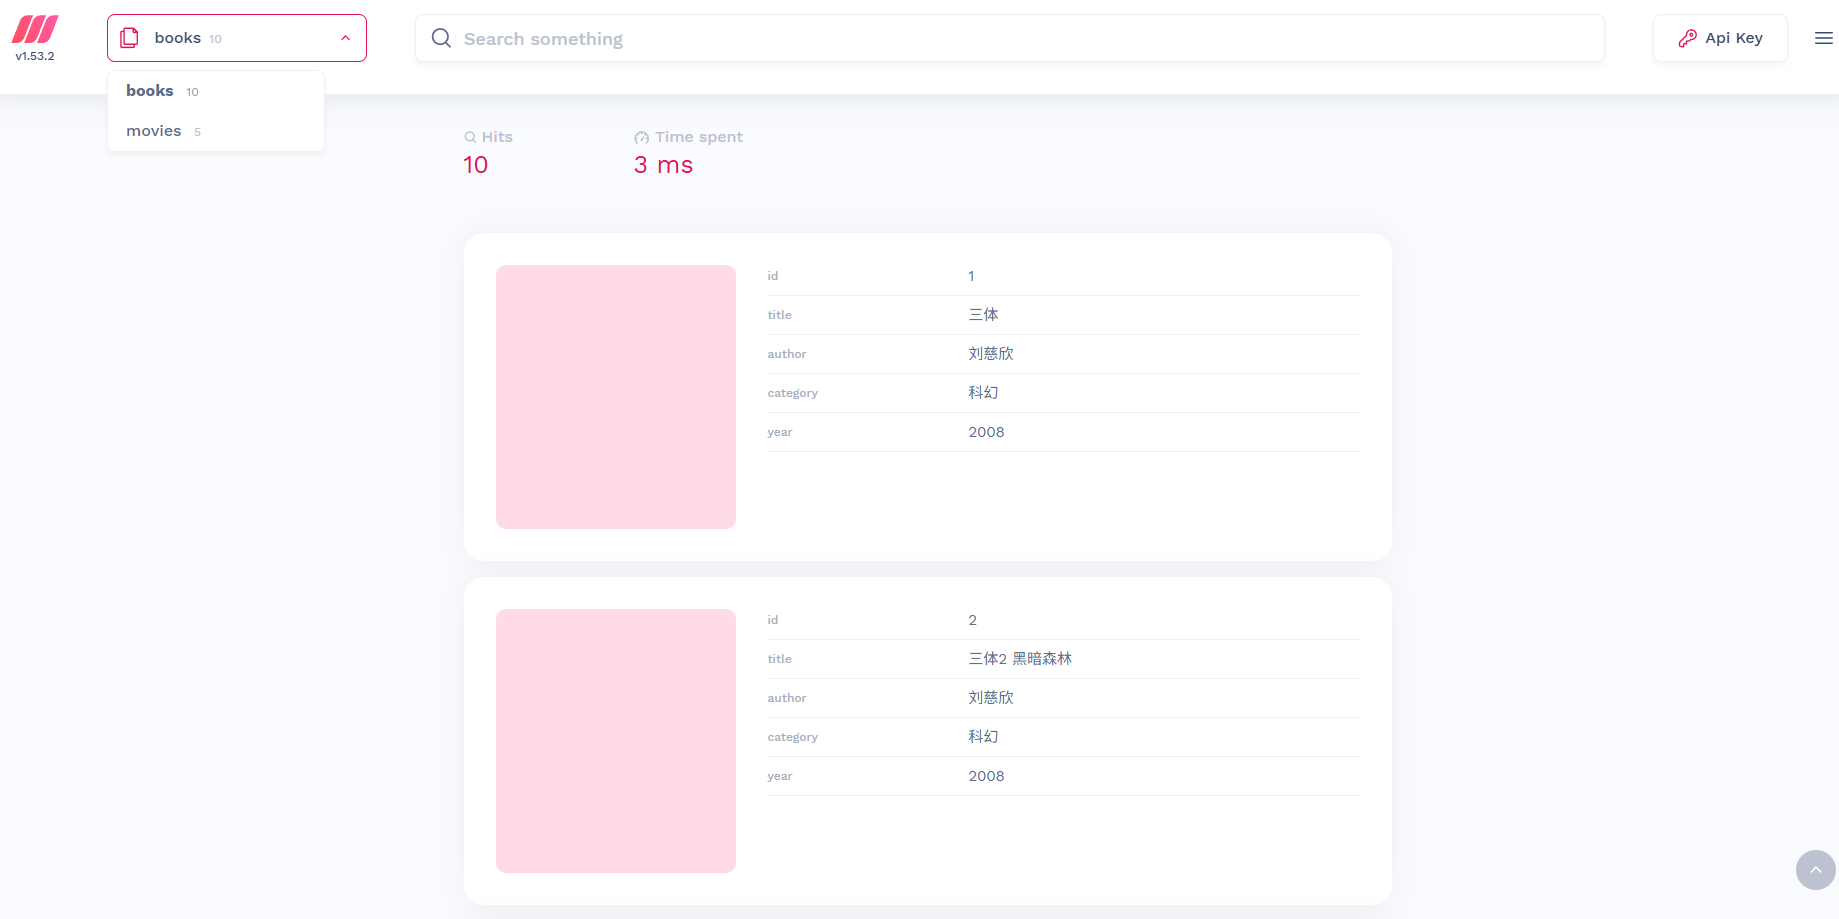
在网页版,输入关键词,即可搜索到:
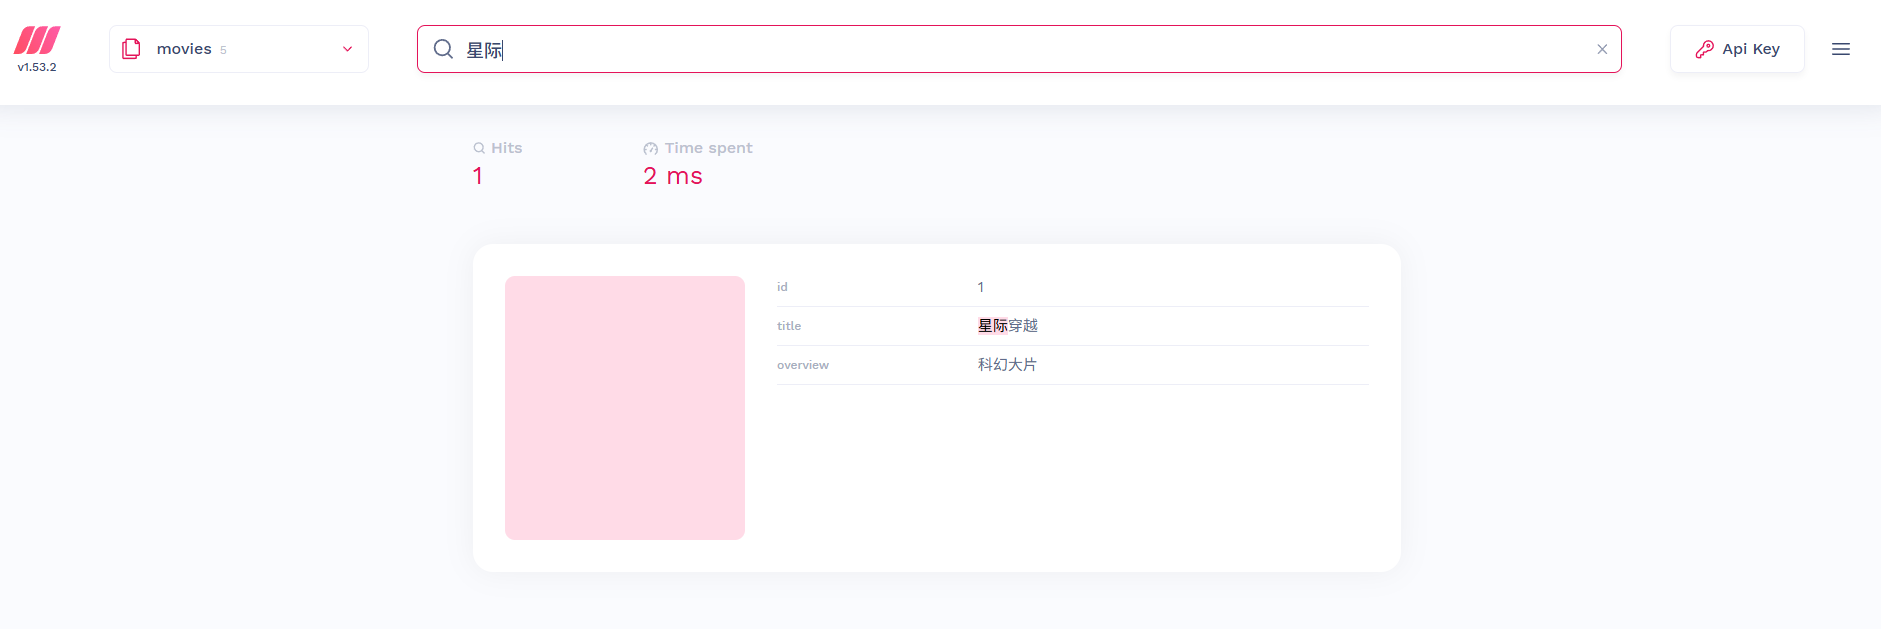
本地部署的Meilisearch自带Web管理面板与搜索API,但默认只能局域网访问;搭配cpolar内网穿透,无需公网IP、不用改路由器,一行命令就能创建加密隧道,把7700端口的Meilisearch服务映射为公网可访问地址,随时随地远程打开Web界面查看movies、books索引,调用API测试全文检索、错别字纠错、筛选排序等搜索能力,适合开发调试、异地演示搜索功能;注意生产环境务必做好密钥防护,不要直接裸暴露公网。
5.安装cpolar实现随时随地开发
5.1 什么是cpolar?
cpolar是一款安全高效的内网穿透工具,无需公网IP或复杂配置,只需一条命令,即可将本地服务器、Web服务或任意端口映射到公网,让你随时随地远程访问内网应用,特别适合开发调试、远程运维和应急部署等场景。
5.2 部署cpolar
cpolar可以将你本地电脑中的服务(如SSH、Web、数据库)映射到公网。即使你在家里或外出时,也可以通过公网地址连接回本地运行的开发环境。
❤️以下是安装cpolar步骤:
使用一键脚本安装命令:
sudo curl https://get.cpolar.sh | sh
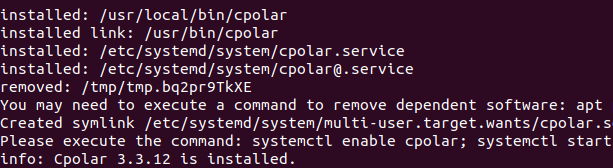
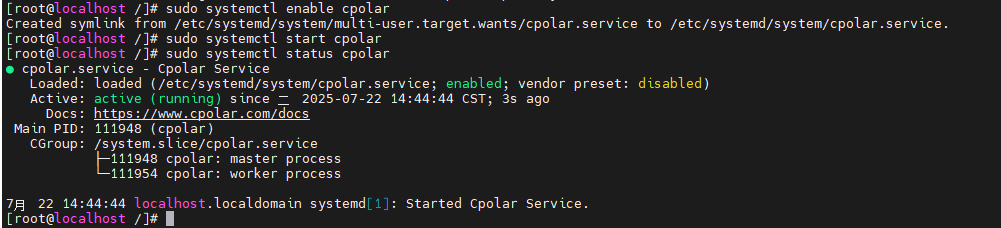
安装完成后,执行下方命令查看cpolar服务状态:(如图所示即为正常启动)
sudo systemctl status cpolar
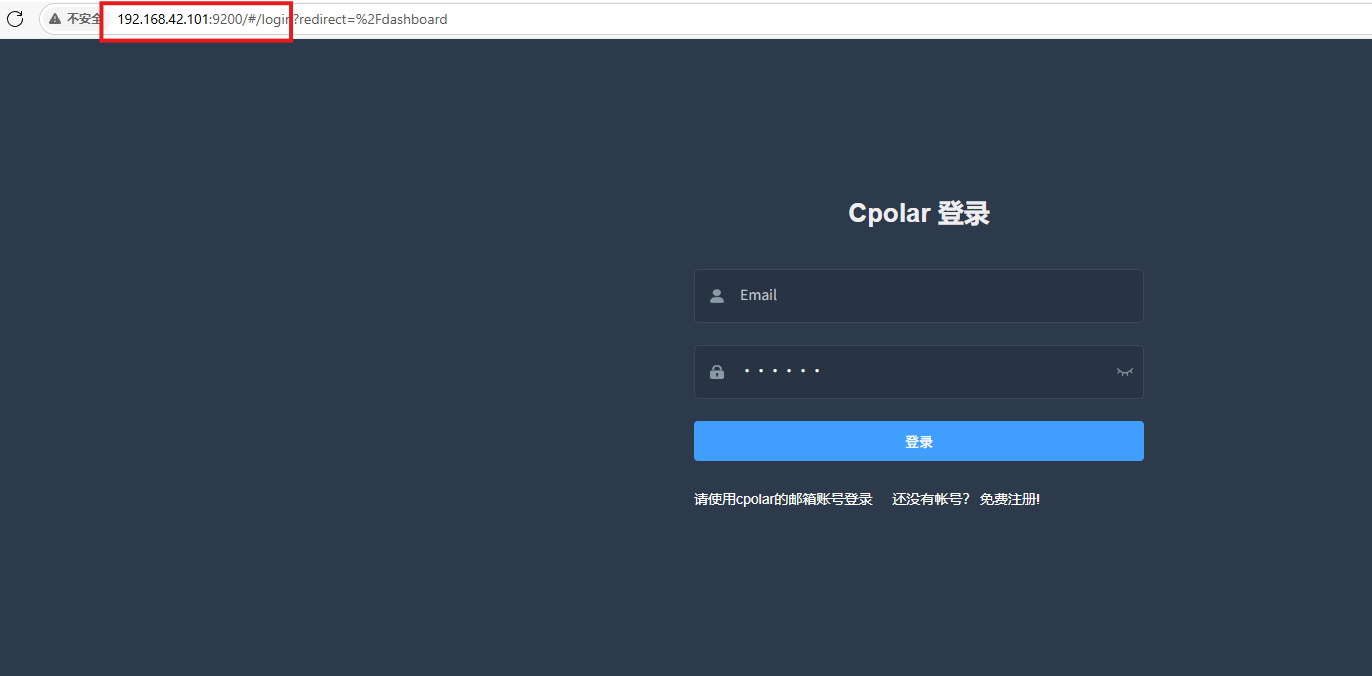
Cpolar安装和成功启动服务后,在浏览器上输入虚拟机主机IP加9200端口即:【http://ip:9200】访问Cpolar管理界面,使用Cpolar官网注册的账号登录,登录后即可看到cpolar web 配置界面,接下来在web 界面配置即可:
打开浏览器访问本地9200端口,使用cpolar账户密码登录即可,登录后即可对隧道进行管理。
6.配置公网地址
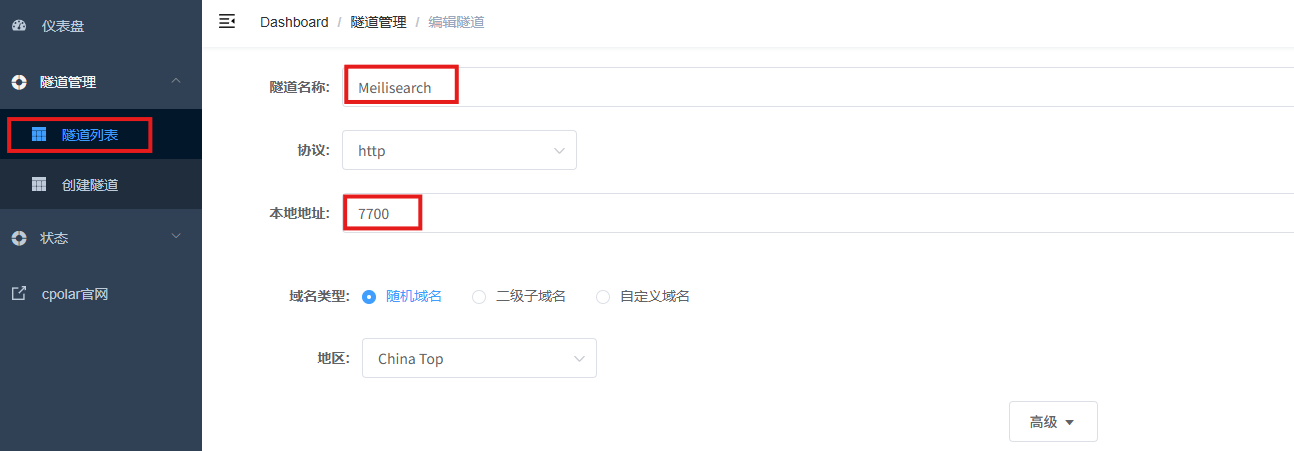
登录cpolar web UI管理界面后,点击左侧仪表盘的隧道管理——创建隧道:
- 隧道名称:可自定义,本例使用了:Meilisearch,注意不要与已有的隧道名称重复
- 协议:http
- 本地地址:7700
- 域名类型:随机域名
- 地区:选择China Top
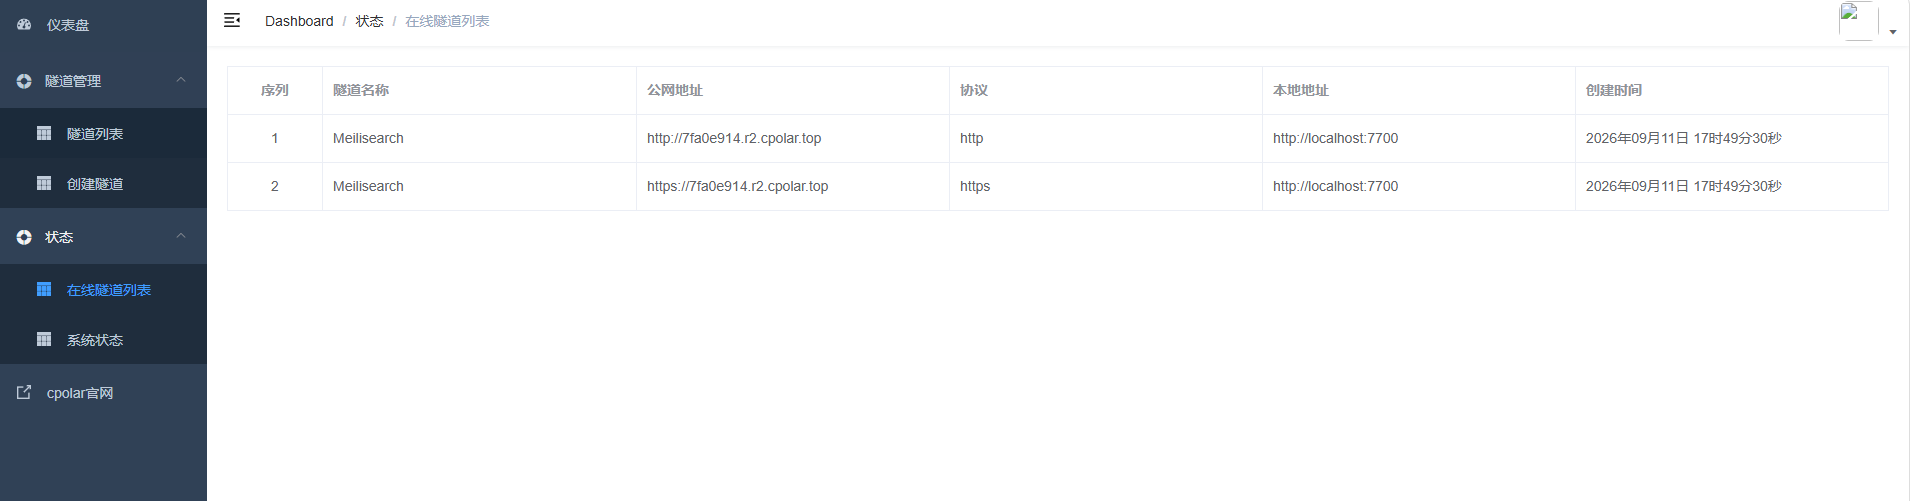
创建成功后,打开左侧在线隧道列表,可以看到刚刚通过创建隧道生成了公网地址,接下来就可以在其他电脑或者移动端设备(异地)上,使用地址访问。
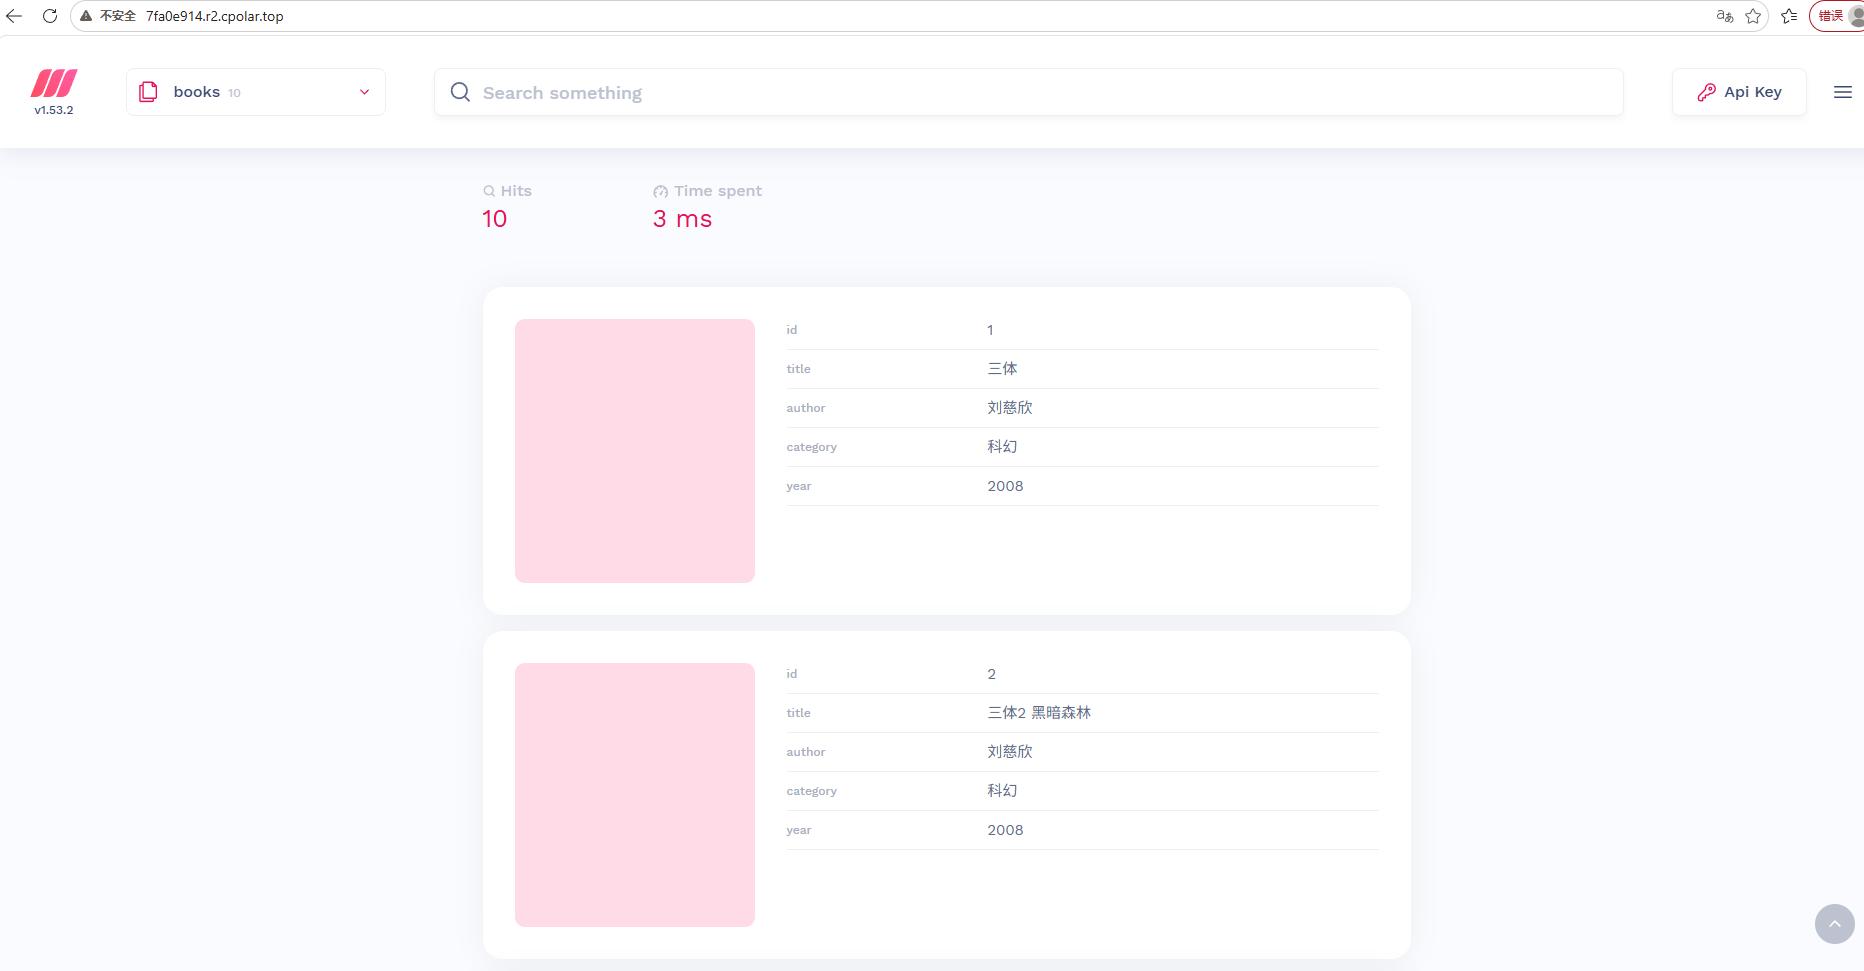
访问成功。
7.保留固定公网地址
使用cpolar为其配置二级子域名(cpolar官网-安全的内网穿透工具 | 无需公网ip | 远程访问 | 搭建网站),该地址为固定地址,不会随机变化。
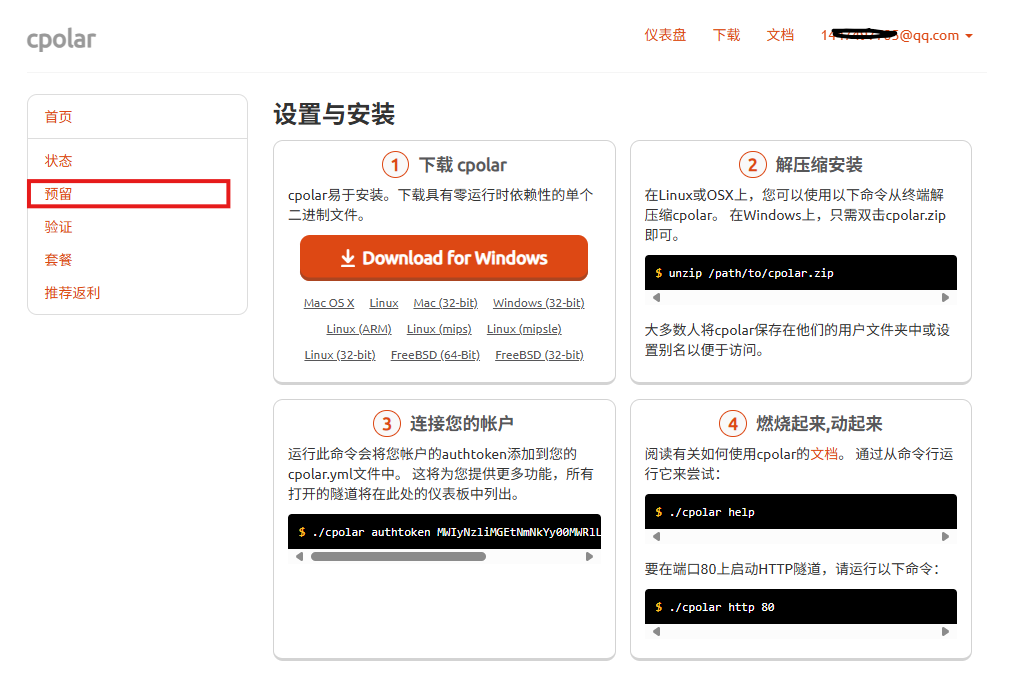
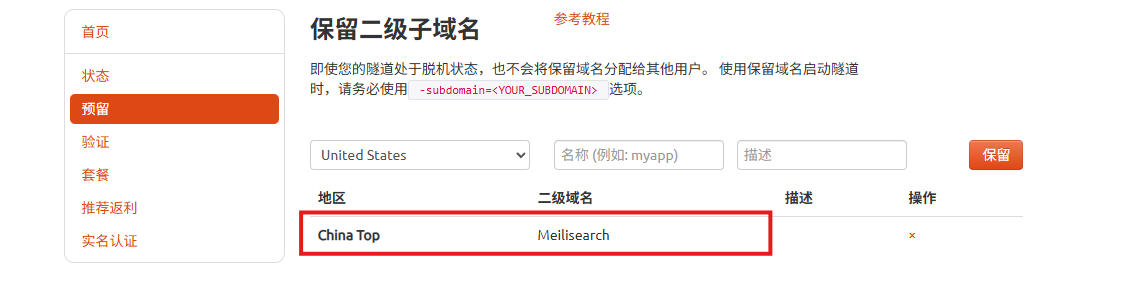
点击左侧的预留,选择保留二级子域名,地区选择china Top,然后设置一个二级子域名名称,我使用的是Meilisearch,大家可以自定义。填写备注信息,点击保留。
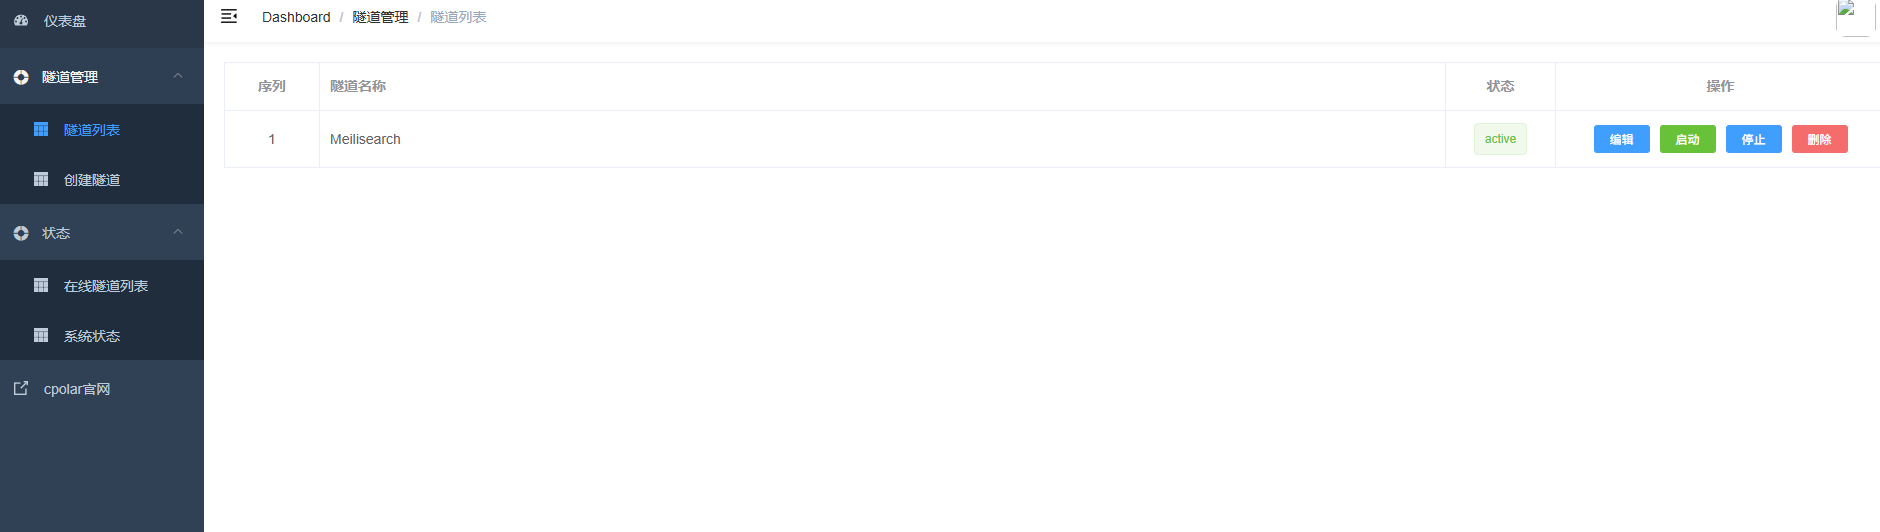
登录cpolar web UI管理界面,点击左侧仪表盘的隧道管理——隧道列表,找到所要配置的隧道,点击右侧的编辑。
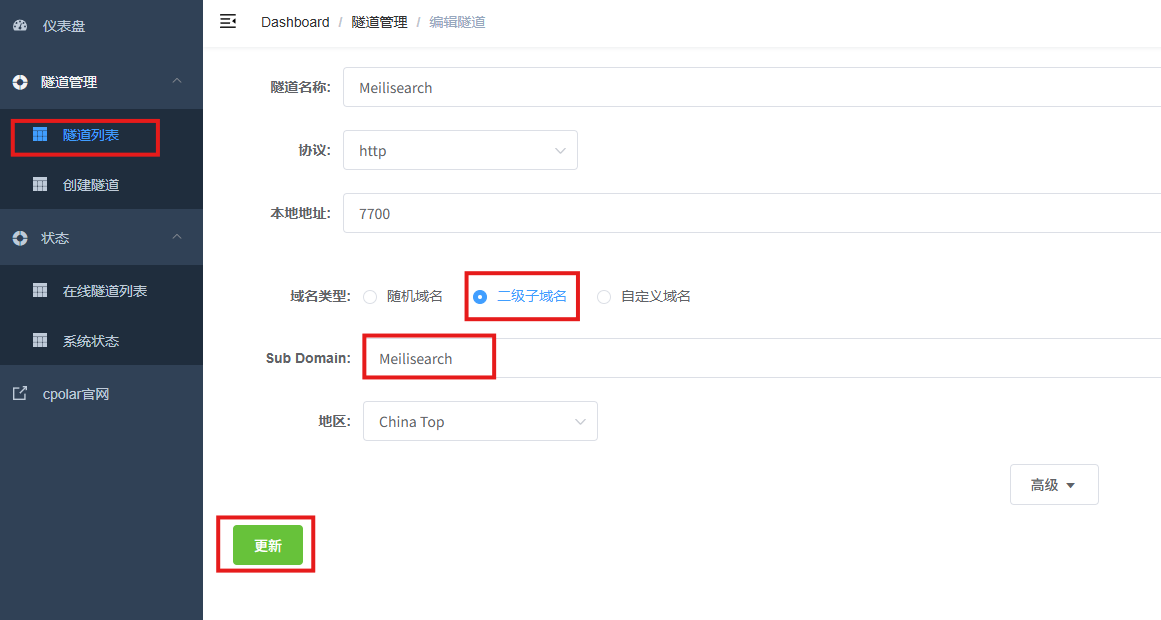
修改隧道信息,将保留成功的二级子域名配置到隧道中
- 域名类型:选择二级子域名
- Sub Domain:填写保留成功的二级子域名
- 地区: China Top
点击更新
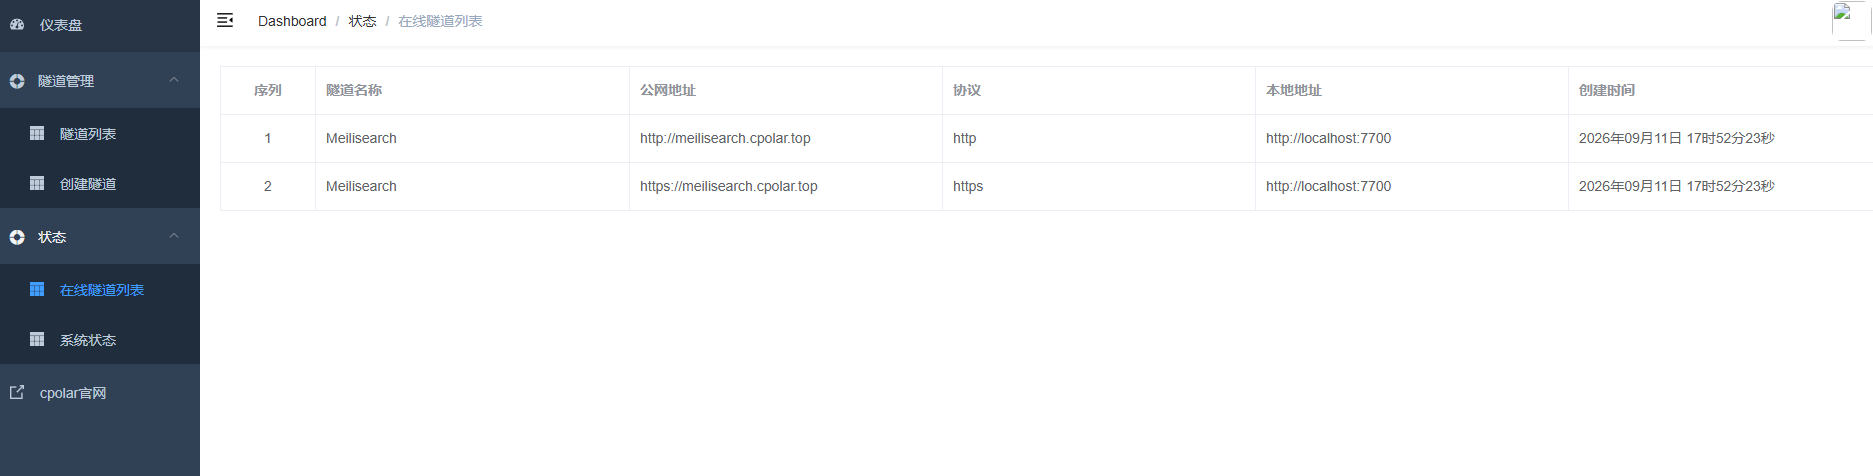
更新完成后,打开在线隧道列表,此时可以看到随机的公网地址已经发生变化,地址名称也变成了保留和固定的二级子域名名称。
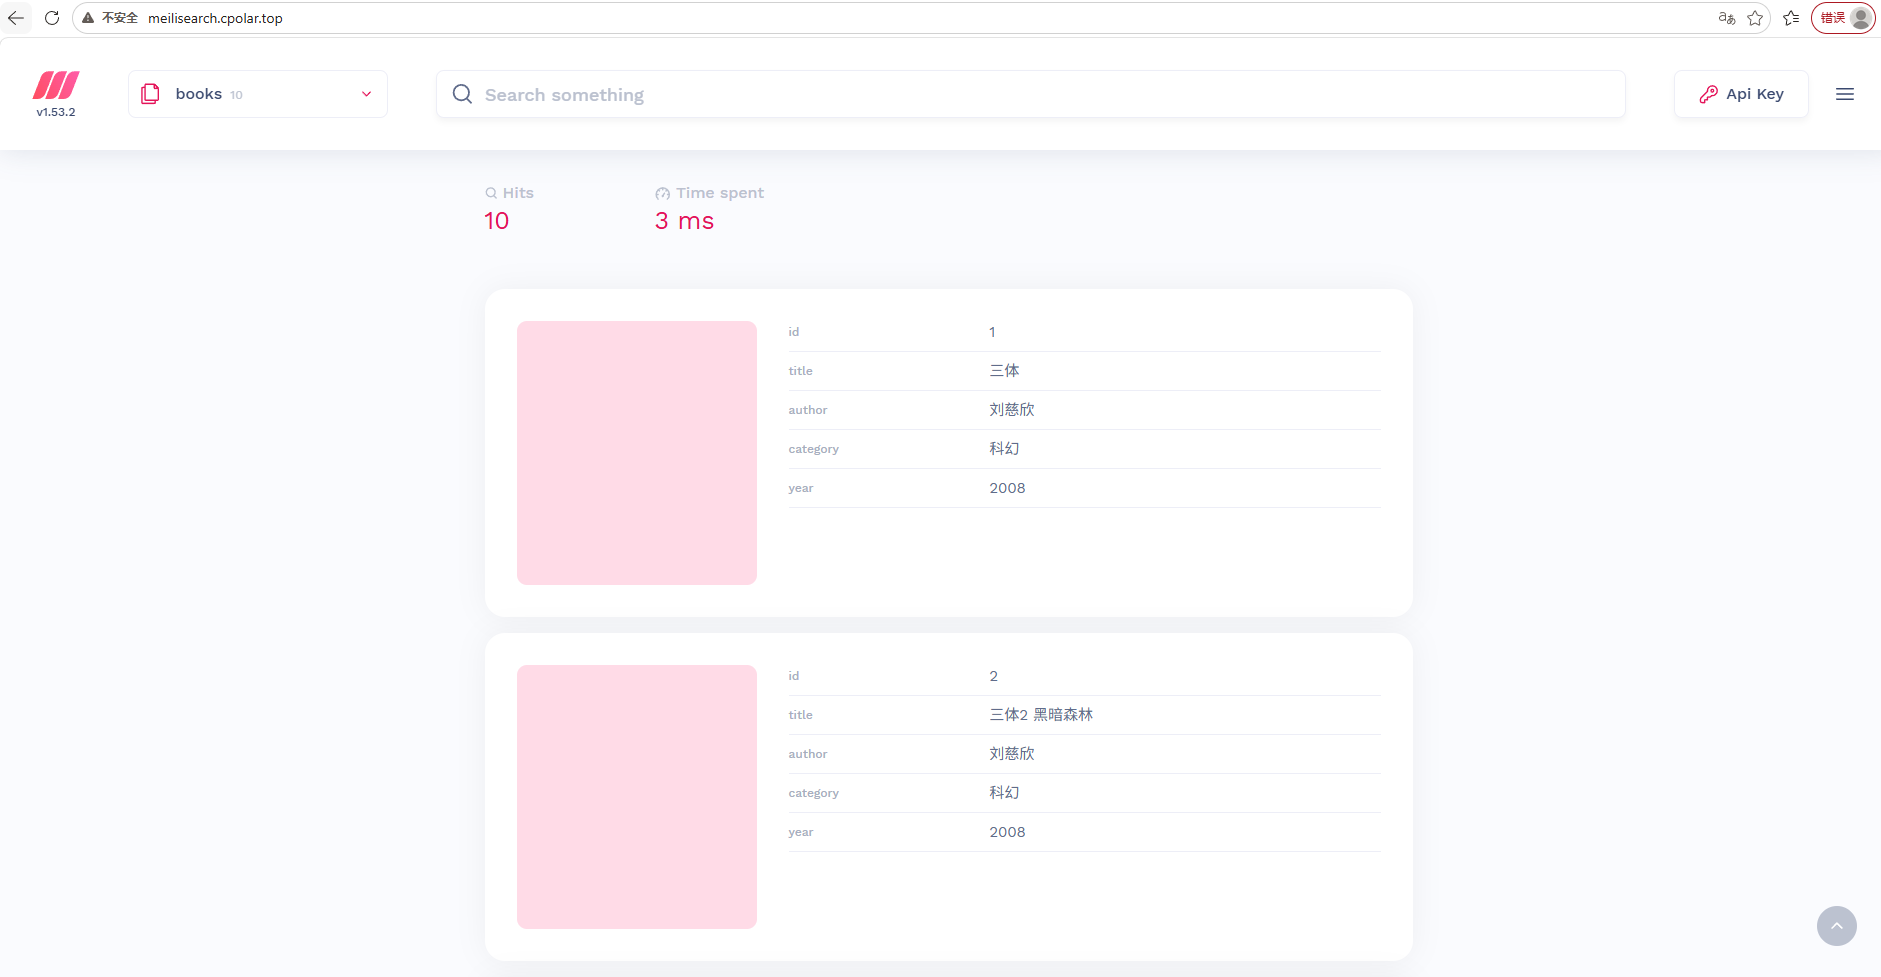
最后,我们使用固定的公网地址在任意设备的浏览器中访问,可以看到成功访问的页面,这样一个永久不会变化的二级子域名公网网址即设置好了。
总结
本文带我们从零上手Meilisearch轻量全文检索引擎,从基础概念到完整实操。先理解索引如同数据库数据表,用来归类存放同类文档,文档就是一条条业务数据;我们亲手创建movies电影索引、books图书索引,导入多组测试数据,利用内置Web可视化面板直观查看数据。
Meilisearch开箱即用,原生支持中文检索,自带拼写纠错、相关度排序,还能实现字段权重配置、关键词检索、条件过滤、分页、分面搜索等高级能力。它一次搜索只能查询单个索引,跨类型检索可以采用多次请求后端合并结果的方案。
本地部署的Meilisearch默认仅局域网访问,搭配cpolar内网穿透,不用公网IP,一键把7700端口服务暴露到公网,随时随地远程访问Web面板、调用搜索API,非常适合开发演示。实操中需要留意系统磁盘空间,Z4S这类小系统盘设备不要把下载文件、大容量ISO镜像放在系统分区,否则会出现磁盘占满、cpolar配置写入失败等故障;同时公网暴露时务必保护好Master密钥,避免数据安全风险。
整套流程门槛低,不用复杂的分词配置,适合个人站点、知识库、后台业务检索场景快速落地全文搜索。
感谢您对本篇文章的喜爱,有任何问题欢迎留言交流。cpolar官网-安全的内网穿透工具 | 无需公网ip | 远程访问 | 搭建网站